RAG na prática: como ligar seus documentos a um LLM
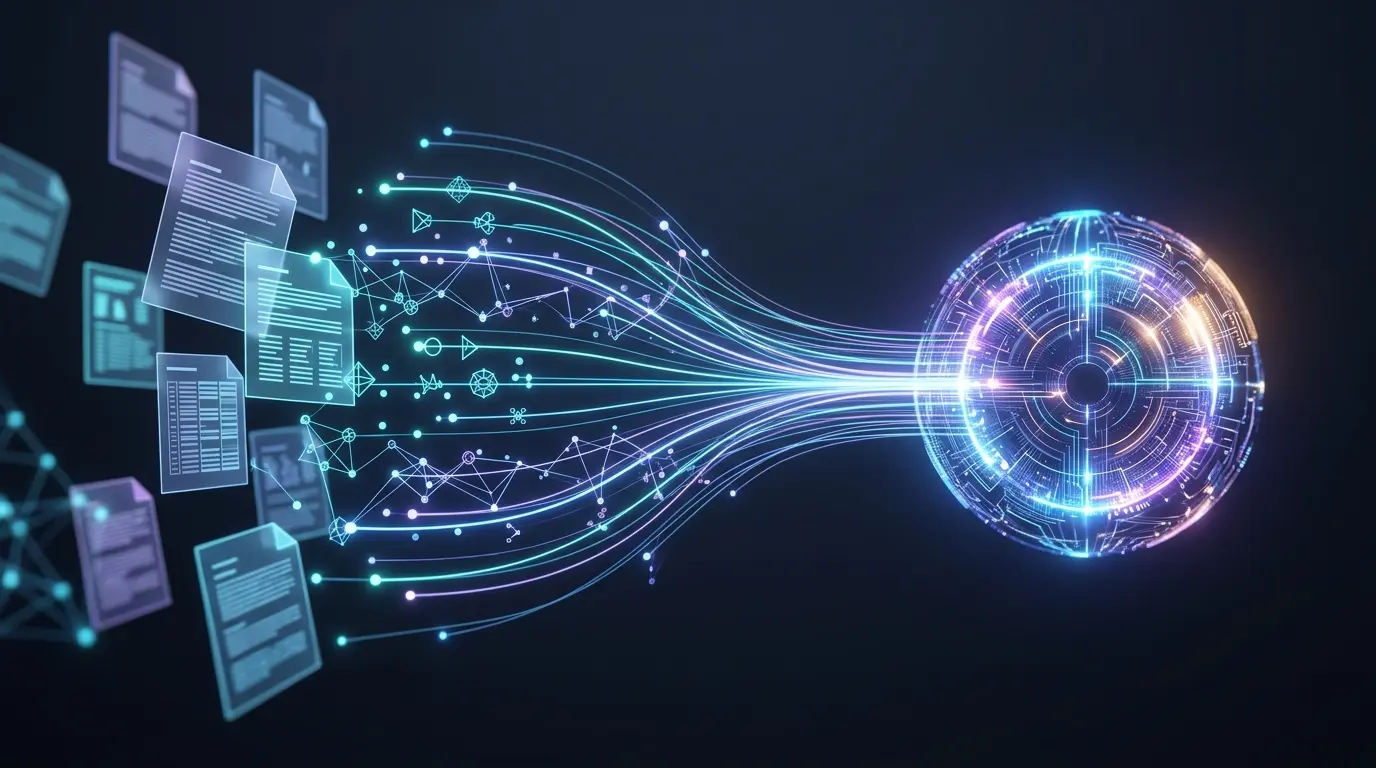
Aplicar RAG na prática significa conectar o seu próprio banco de dados a um modelo de linguagem. Isso resolve o problema das alucinações nas respostas. Você não precisa gastar milhões em treinamento do zero. Basta usar a técnica de Retrieval-Augmented Generation.
Muitos desenvolvedores acham a criação de IA complexa. O segredo é a arquitetura correta. Você usa vetores para buscar o contexto exato. Depois, envia esse contexto ao modelo. Assim, a IA responde com base apenas nos seus arquivos.
Para entender a teoria básica, leia o nosso comparativo de bancos de dados vetoriais. Os embeddings são o motor de busca principal. Sem bons embeddings densos, o texto escrito não vira número. Os cálculos matemáticos de similaridade dependem deles totalmente. O sistema converte documentos e os armazena com segurança. O banco de dados guarda os números extraídos. Pinecone e ChromaDB são ótimas opções iniciais. Eles calculam a distância exata entre a pergunta feita e os textos longos. A resposta mais próxima vai para o prompt da IA. Essa etapa é absolutamente crítica para o sucesso técnico.
Por que usar RAG na prática?
Empresas perdem muito dinheiro com chatbots que inventam dados corporativos. A solução inteligente envolve bancos vetoriais. O modelo lê o seu documento restrito antes de falar. Isso evita riscos jurídicos graves. Veja os benefícios reais e os números práticos dessa abordagem fantástica no dia a dia.
| Abordagem Técnica | Custo Inicial Médio | Precisão dos Dados |
|---|---|---|
| Fine-tuning Tradicional | Muito Alto | Média e Desatualizada |
| Arquitetura Moderna RAG | Bastante Baixo | Alta e Em Tempo Real |
A tabela acima mostra diferenças claras e essenciais. O custo operacional mensal do sistema é muito menor. Além disso, a precisão para arquivos corporativos dispara. Você insere novos PDFs grandes no sistema e o software atualiza tudo imediatamente. Não exige retreinamento contínuo da pesada rede neural.
Implementações recentes no mercado mostram números operacionais muito fortes. O tempo médio total de resposta caiu para meros 2 segundos. O custo financeiro do servidor ficou abaixo de 100 dólares por um mês inteiro.
Essas métricas exatas provam o valor da tecnologia. O desenvolvimento de software é rápido e ágil. Um protótipo corporativo moderno funciona perfeitamente em apenas 3 dias. A manutenção sistêmica exige apenas atualizar os arquivos originais. O modelo computacional não perde conhecimento com o passar do tempo.
Como configurar o banco vetorial?
O código limpo é a melhor forma possível de aprender. Vamos usar linguagem Python básica. A biblioteca avançada LangChain facilita tudo isso rapidamente. Primeiro passo, você carrega os documentos de texto cru. Depois disso, quebra o texto enorme em partes bem menores. A comunidade chama isso de chunking estruturado.
from langchain.document_loaders import TextLoader
loader = TextLoader("meus_dados.txt")
docs = loader.load()
print(len(docs))
Observe com atenção o pequeno script de exemplo acima. Carregamos um arquivo de texto simples diretamente do disco local. A próxima etapa crucial de programação é criar os embeddings numéricos. Você pode usar a poderosa API externa da OpenAI. Ou rodar um pequeno modelo local da HuggingFace. A escolha afeta o custo diretamente.
- Instale todas as bibliotecas Python necessárias no ambiente virtual.
- Defina o tamanho exato matemático do chunk textual.
- Escolha um banco de dados focado em vetores que seja confiável.
- Execute a indexação inicial pesada dos seus documentos textuais.
- Teste exaustivamente as buscas de similaridade no seu terminal web.
Qual é o código para a geração das respostas?
Agora nós já temos o contexto exato processado. O passo final lógico na aplicação é a geração textual coerente. O LLM escolhido recebe a sua pergunta enviada. Ele também recebe o trecho exato do documento corporativo encontrado. A instrução dada à máquina pensante é muito clara. Pedimos educadamente que responda baseando-se apenas naquele texto isolado.
qa_chain = RetrievalQA.from_chain_type(
    llm=OpenAI(),
    retriever=db.as_retriever()
)
resposta = qa_chain.run("Qual a política de férias interna?")
print(resposta)
Esse bloco de código final junta todas as partes soltas. Ele cria a complexa e essencial corrente de raciocínio lógico. O sistema autônomo vai buscar a política de férias da equipe. Depois, a IA formula uma resposta em formato legível. Você pode escolher LLMs com código aberto para esse fim. Eles rodam muito bem até em pequenos servidores de desenvolvedores.
A comunidade mundial avança muito rápido na área técnica. Novas e incríveis técnicas aprimoradas de busca surgem toda semana. Os sistemas atuais agora incluem roteamento flexível e re-ranking de vetores. O famoso portal de modelos do Hugging Face possui os melhores pesos. Você pode baixar os arquivos grandes e testar as redes localmente. Isso garante o total e absoluto sigilo dos dados da sua empresa.
Os primeiros testes práticos isolados podem falhar um pouco. A IA ainda pode acabar inventando pequenas informações erradas. Isso ocorre sempre que a busca vetorial principal falhar miseravelmente. O tamanho exato numérico do chunk influencia muito neste aspecto crítico. Pedaços muito grandes de parágrafos diluem a informação principal extraída. Pedaços curtos perdem totalmente o sentido original do escritor.
A grande solução profissional é ajustar bem os hiperparâmetros sistêmicos. Teste calmamente taxas de sobreposições de texto de 10% a 20%. Isso mantém as longas frases devidamente conectadas logicamente. Outro truque genial atual é gerar múltiplas perguntas sintéticas variadas. O sistema inteligente pesquisa inúmeras variações da dúvida original recebida.
O tamanho geral do modelo de linguagem também importa bastante. Modelos maiores bilionários entendem contextos muito longos perfeitamente. Modelos menores e mais leves precisam de recortes de contexto incrivelmente precisos. Analise os registros e logs diários do seu sistema frequentemente. Identifique exatamente quais perguntas humanas reais falham com frequência diária. Aprimore gradualmente os manuais de base com as respostas textuais super corretas.